

 スクラムマスター(21)
【Dify】チームの議事録を食わせて動くAIアシスタントを作った
 Claude Code


はじめに
最近は議事録をAIにとらせている現場が多いのではないでしょうか。
そういった眠った議事録にはチームのコンテキストが埋まっています。
メンバーズでスクラムマスター兼エンジニアとして業務している私ですが、これをなんとか活用できないかと私たちのチームは考えていました。
このチームには、自分たちが積み上げてきた活動や学びを、継続的に言語化し可視化したいという課題感がありました。
日々の支援活動は議事録やMiroに散在していて、半期をふりかえろうとしたときに「何をやったんだっけ」を集めること自体に手間がかかっていたのです。
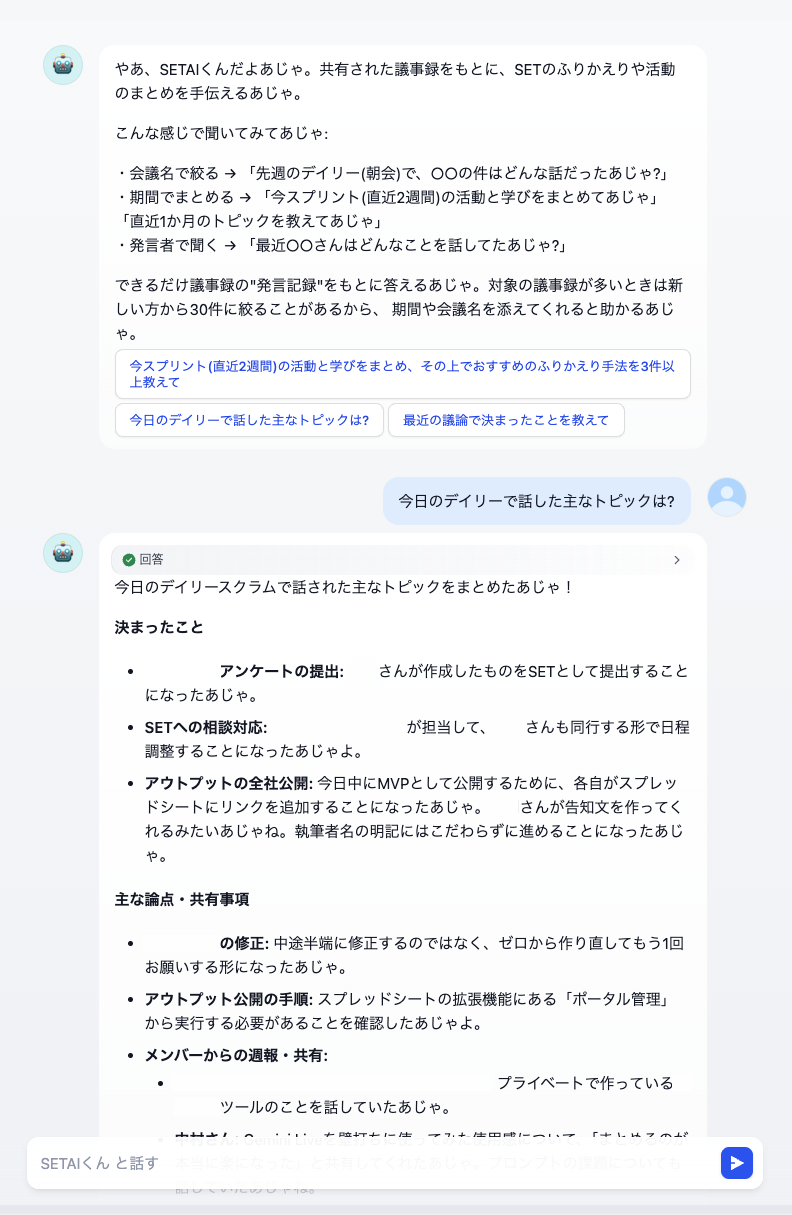
そこで、議事録を読み込んでチームの文脈を汲み取り、ふりかえりを支援するAIアシスタント「SETAIくん」(読み: せたいくん)を作りました。
所属のチーム名がScrum Evangelist Teamで、そのコンテキストを保持するAIなのでSETAIくんです。
単なる業務効率化ツールではありません。
チームが自分たちの価値を継続的に言語化していくための仕組み、という位置づけです。
記事の要約(TL;DR)
半期のふりかえりで「何をやったか」を集める手間を減らすため、議事録を読み込むAIアシスタント「SETAIくん(せたいくん)」を作った
チャットボット本体1つと、Dify(ノーコードでLLMワークフローを組めるプラットフォーム)上で動く定期実行ワークフロー数本の組み合わせで動いている
実現方式の決め手は技術力ではなく、社内の生成AI利用ガイドライン上の入力制限だった
実装では「プラットフォームの標準機能を捨てて自前ロジックに倒す」判断があった
この記事は汎用フレームワークの提案ではなく、1チームの試行錯誤の実践報告である
まずは「ふりかえれること」をゴールとした
最初に決めたのは「これができたら成功」というラインで、この3つに絞りました。
チームの活動コンテキスト(レトロスペクティブ、デイリーなどの議事録)を把握する
スプリントで「やったこと」をリストアップできる
ふりかえりの場で「やったこと」を提示し、さらに「こんなふりかえり方はどうか」まで提案できる
RAGやAIアシスタントを作るとき、「精度」をどう測るかは案外難しいです。
回答の正しさを個別に採点する方法もあるが、手間がかかるうえに実際の使われ方と乖離しやすくなります。
そこでSETAIくんでは、成功判定を「ふりかえれること自体が、コンテキストを把握できていることの証」と定義しました。
実際のふりかえりの場で使えるかどうかを、そのまま評価指標にしたのです。
使えなければ、それはコンテキストが足りていないということになります。
この置き方によって、評価のための評価をせずに済みました。
なお、これは開発初期に据えた最初のゴールであり、継続的に精度を測定して記録する仕組みとして運用しているわけではない。
実現方式を選んだ決め手は、技術的な好みではなく社内ルールだった
議事録には当然、メンバーの発言が発言者名つきで入っています。
社内の生成AI利用ガイドライン上、こうした個人情報を扱える生成AIサービスは限られていました。
その上で、方式そのものはいったんゼロベースで洗い直しました。
当初は「汎用AIサービスのプロジェクト機能を使う」という前提で設計していたが、ある時点でそれが確定事項ではないと気づき、前提を明示的に訂正して選択肢を並べ直しています。
比較したのは次の4つです。
方式 | コンテキストの投入 | 実行トリガー | 論点 |
A. Claudeのプロジェクト機能 | 手動で貼り付け・添付 | 人が都度会話する | 構築コストは最小だが自動化できない |
B. GeminiやDify基盤上にアプリを構築 | API経由で自動連携できる | 定期実行やWebhookで自動化できる | 構築工数は増える |
C. リポジトリにSkills/Agentsを定義しClaudeをローカル実行 | リポジトリ内のファイルから自動で読む | 各自が任意のタイミングで起動 | 全員がCLIを扱えるとは限らない |
D. Cに加えて定期実行を組む | 同上 | 完全に自動化できる | 最も仕組み化されるが保守コストが最大 |
判断軸は、構築スピード、保守コスト、メンバーのスキルセット、ガイドラインへの適合性、そして将来の自動化の必要性です。
Aは「人が毎回貼り付ける」運用から抜けられません。
C・Dはメンバー全員がローカル環境とCLI操作に対応できるかが読めませんでした。
最終的に採ったのはB、すなわち社内で利用できる生成AI基盤上にアプリを構築する方式です。
その中でGeminiではなくDifyを選んだのは、定期実行やAPI連携で自動化できること、GUIでワークフローを組めるためCLIに不慣れなメンバーも中身を追えることが理由になりました。
AIアシスタントの実現方式は、技術的な優劣だけでは決まりません。
扱うデータの機微度と、社内ルール上の分類が最初の制約条件になりました。
SETAIくんは一体のチャットボットではなく、複数の定期実行ワークフローの集合体
現在動いているのは、単なるチャットボットではありません。
Dify上に構築した、チャットアプリと複数のバッチワークフローの集合という構成です。
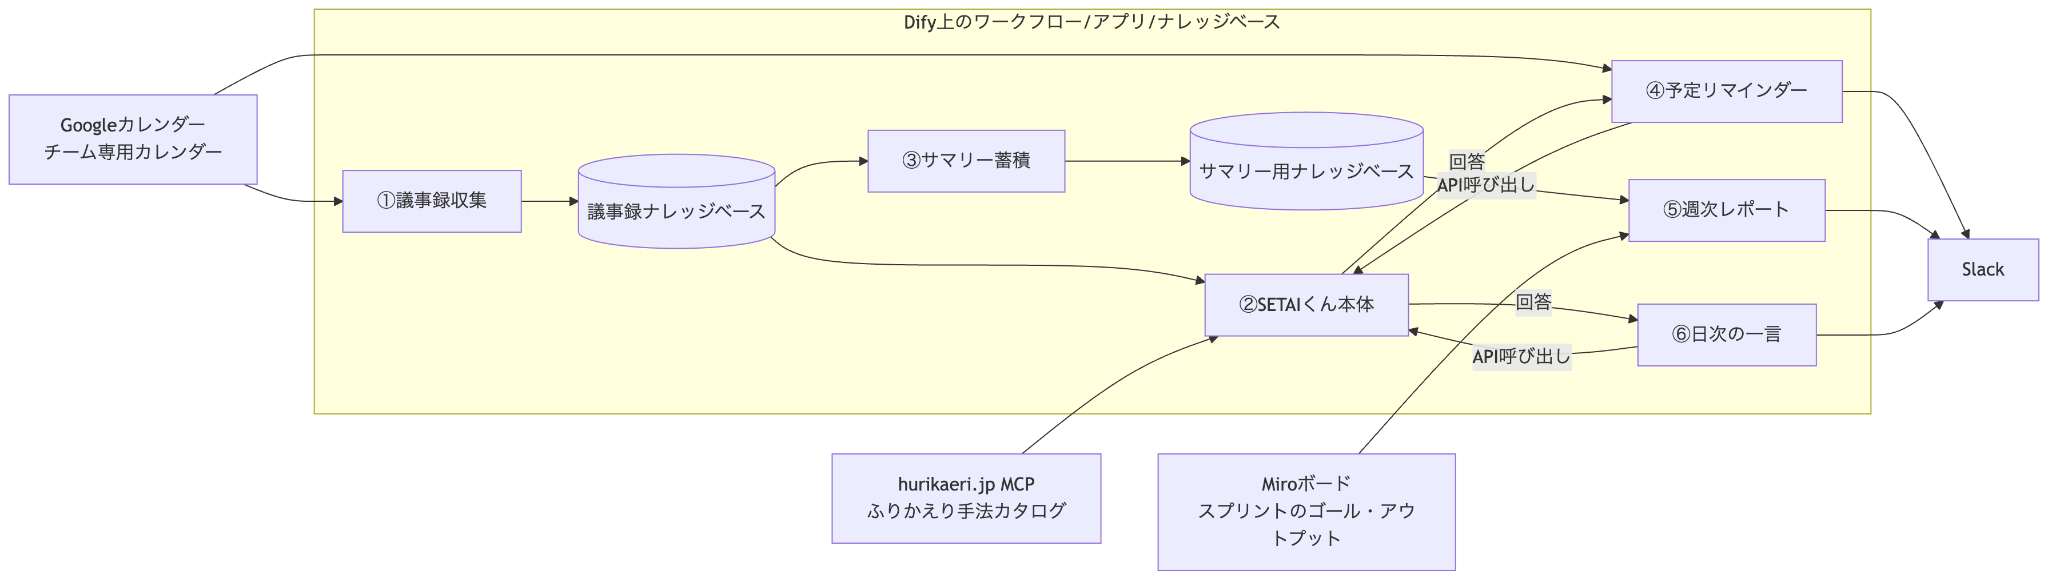
①議事録収集、②SETAIくん本体、③サマリー蓄積、④予定リマインダー、⑤週次レポート、⑥日次の一言。
この6つのワークフロー/アプリが、役割ごとに独立して動いています。
④予定リマインダーと⑥日次の一言は、自前でナレッジベースを検索するのではなく、②SETAIくん本体をAPI経由で呼び出してその回答をSlackへ流しています。
チャットアプリ本体だけがSlackから直接呼び出せない状態なので(後述)、Slackへの通知はすべてバッチワークフロー側から行っています。
①議事録収集:登録済みかどうかの判定をどう軽くしたか
チーム専用カレンダーの予定に添付された議事録(自動生成メモ)を、毎時の定期実行で検知し、ナレッジベースへ登録するワークフローです。
議事録は一度登録したら内容が変わらない前提なので、既存なら更新せず、スキップするというシンプルな設計にしました。
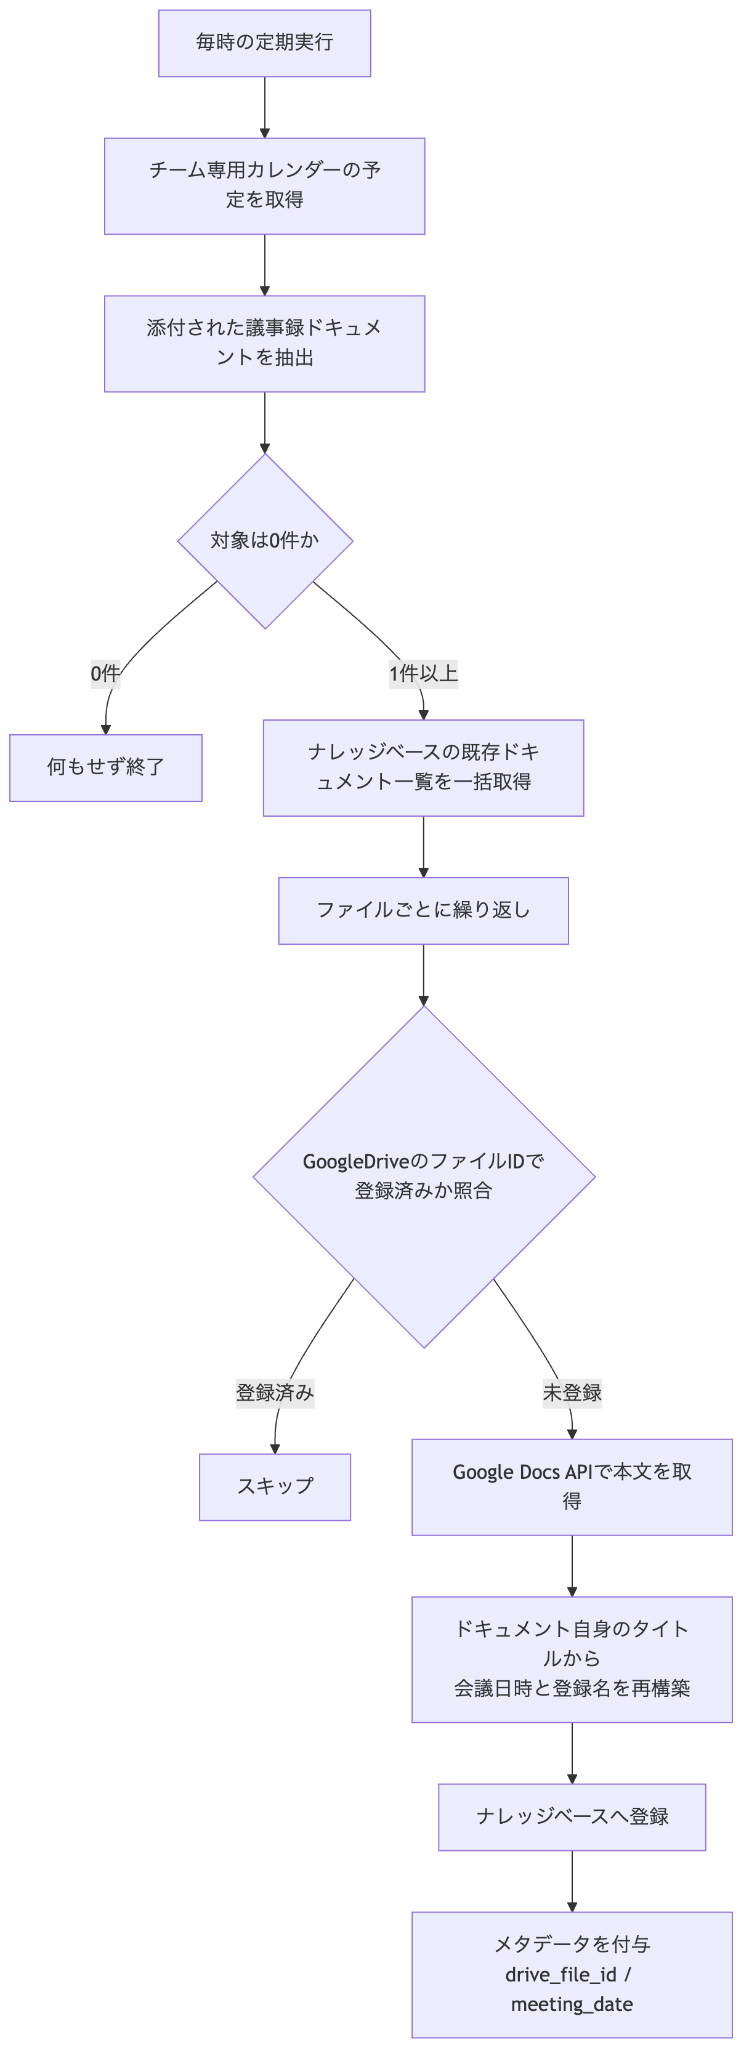
重複判定は、当初ファイルごとに検索APIへ問い合わせていたが、ファイル数に比例してAPIコールが増えすぎました。
全体で1回だけ既存ドキュメント一覧を取得し、ローカルで照合する方式に変えて解決しています。
判定キーもファイル名からGoogleDriveのファイルIDに変えました。
ファイル名は変わりうるが、IDは変わらないからです。
そのIDは、登録後に専用のメタデータ設定APIで付与しています。
ドキュメント作成APIのメタデータ指定パラメータが、フィールドを事前作成していても反映されないことがあったためです。
繰り返し予定では添付ファイルが前回分を引き継ぐことがあるため、会議日時はカレンダーの予定ではなく、取得したドキュメント自身のタイトルから再抽出しています。
本文を取得してからでないとこの再構築ができないので、処理の順序も「登録済み判定 → 本文取得 → 日時の再構築 → 登録 → メタデータ付与」という並びになっています。
運用面では、痛い失敗も一つありました。
テスト用に定期実行の間隔を毎分まで短くし、それを本番のまま戻し忘れてしまったのです。
結果、システム全体のリソースが枯渇し、コンテナの再起動が必要になりました。
技術的な難しさは何もない、完全に人為的なミスです。
だからこそ、誰にでも起きます。
以後、テスト用に変更した設定は明示的に記録し、戻す作業を手順に組み込むようにしました。
実行間隔に下限値のガードレールを設けるといった技術的な対策は、入れていません。
②SETAIくん本体:議事録をまるごと読ませて答えさせる
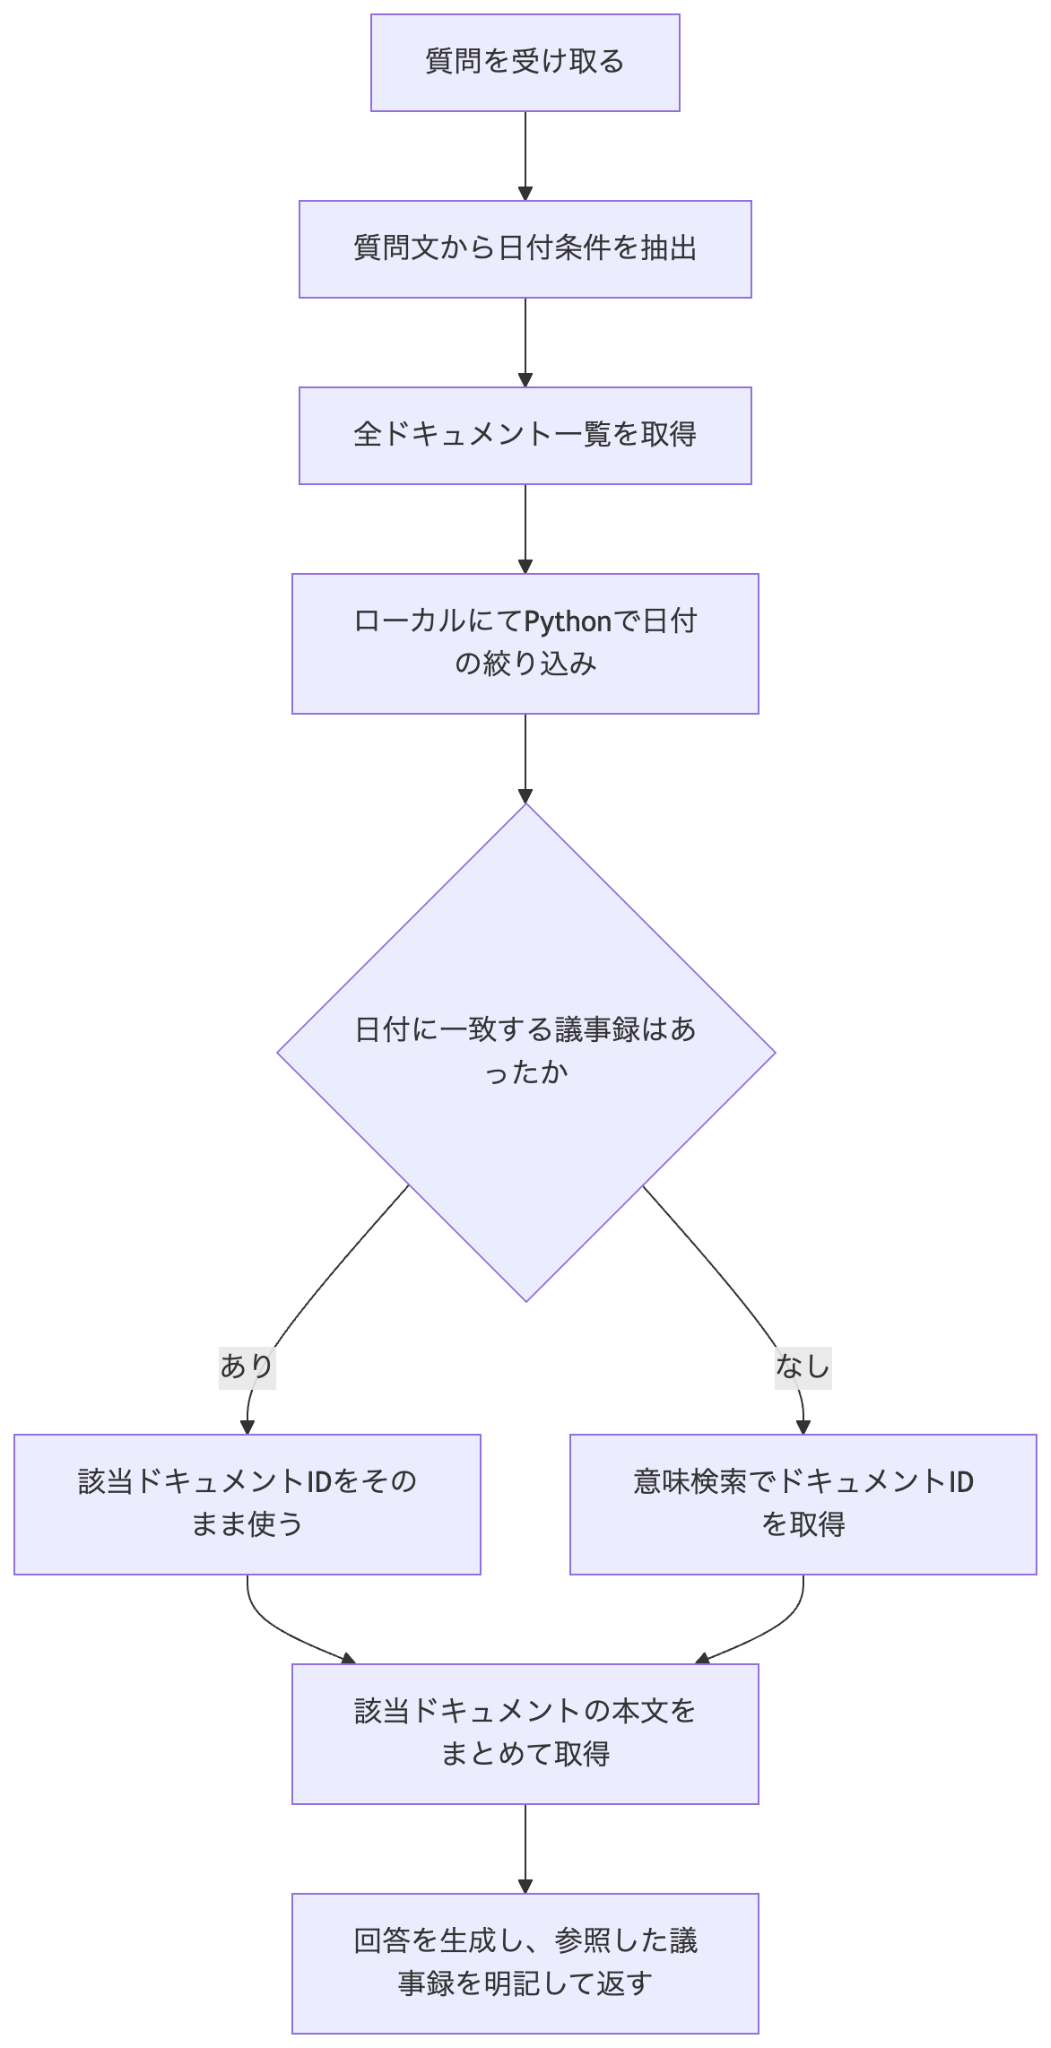
質問を受け取ると、まず質問文から日付条件を抽出します。
次に全ドキュメントの一覧を取得し、コードノード上のPythonでローカルに絞り込みます。
一致する議事録があればそれを直接使い、無ければ意味検索にフォールバックします。
見つかった本文をまとめて取得し、参照した議事録を明記して回答します。
複数の文書から必要な部分を取り出し(map)、それらをまとめて回答を組み立てる(reduce)、いわゆるmap-reduce型の構成です。
作る過程で工夫したのは、主に3つあります。
日付の絞り込み: Dify標準のメタデータフィルタ機能は、比較演算子やAND結合の挙動が不安定でした。上図の通り、全ドキュメントを一括取得してPythonでローカルに絞り込む方式に統一している。枯れた基本APIの組み合わせに倒したほうが、結果的に早かったです。
会議の流れを聞かれた時の弱さ: 「特定の人の発言」や「会議の流れ」を尋ねられると、ベクトル検索の断片的なヒットだけでは拾いきれません。ヒットした文書は全文渡す方式で補いました(検索は小さい単位でヒットさせつつ、参照時は元の文書全体を返す親子チャンキングと、自前での全文再取得の併用)。
API連携の安定性: LLMにリクエストJSONを組み立てさせる実装は不安定でした。組み立てはコードで確実に行い、LLMには判断だけを任せるようにしました。
ふりかえり手法の提案には、記憶で手法名を作らせず、hurikaeri.jpのふりかえり手法カタログをMCP経由で参照させています。
まず目的別に候補を検索し、必要なら手法ごとの詳細を取得して回答に含めるという二段構えです。
③サマリー蓄積:一次情報と二次情報を区別する
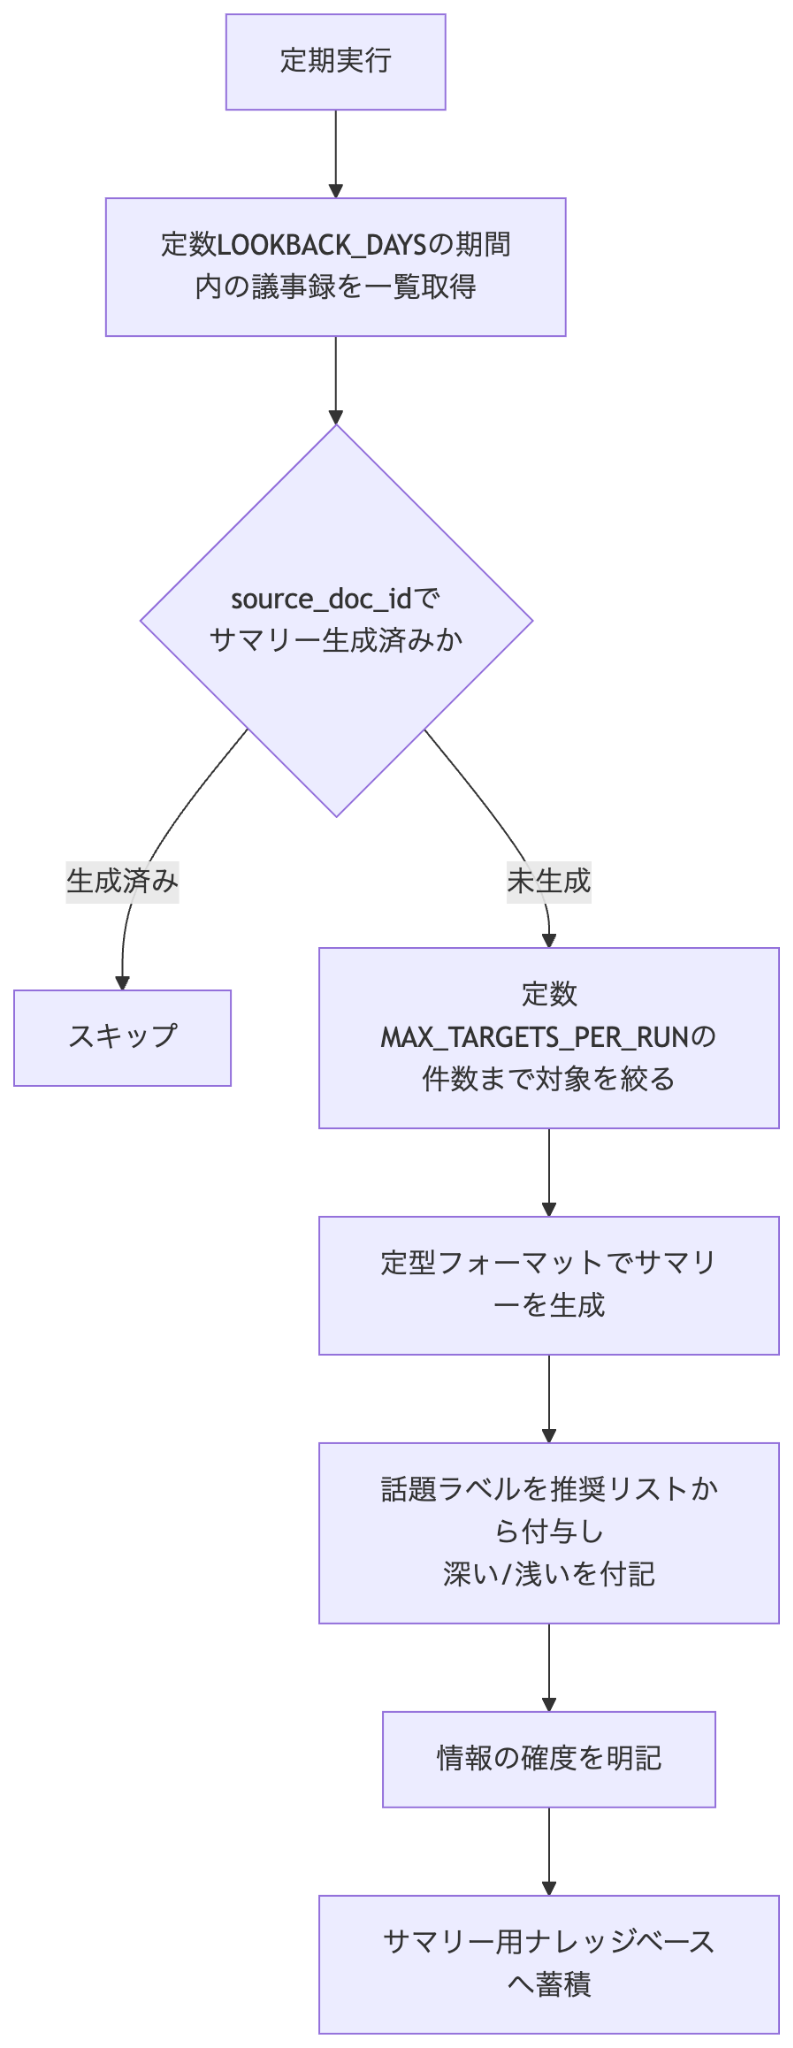
議事録1本ごとに、「話題/やったこと/決めたこと/分かったこと/主な論点/印象的な発言/情報の確度」という定型フォーマットでサマリーを生成し、専用のナレッジベースへ蓄積する定期実行ワークフローです。
新しい議事録の登録をイベントとして受け取るのではなく、定期実行のたびに未処理のものを探しに行くポーリング型になっています。
ゆくゆくはSETAIくんにもサマリーを元に意味検索するようにしたいと思っています。
工夫したのは、一次情報と二次情報の区別です。
議事録には発言者名つきの発言記録と、Geminiに自動生成された要約が混在しています。
プロンプトでは発言者名つきの記述を最優先の一次情報として扱い、自動要約由来の記述は一次情報で埋まらない部分を補う用途にのみ使うよう明示しました。
生成物にも「情報の確度」を明記させ、どちらに基づく記述かを追跡できるようにしています。
話題ラベルも表記揺れを防ぐため、推奨リストを用意しました。
さらに各ラベルには「深い/浅い」を付記させています。
発言者の言葉や具体的なエピソードとして語られた話題と、名前が挙がっただけで流された話題を、後から区別できるようにするためです。
④予定リマインダー:会議前に過去の文脈を届ける
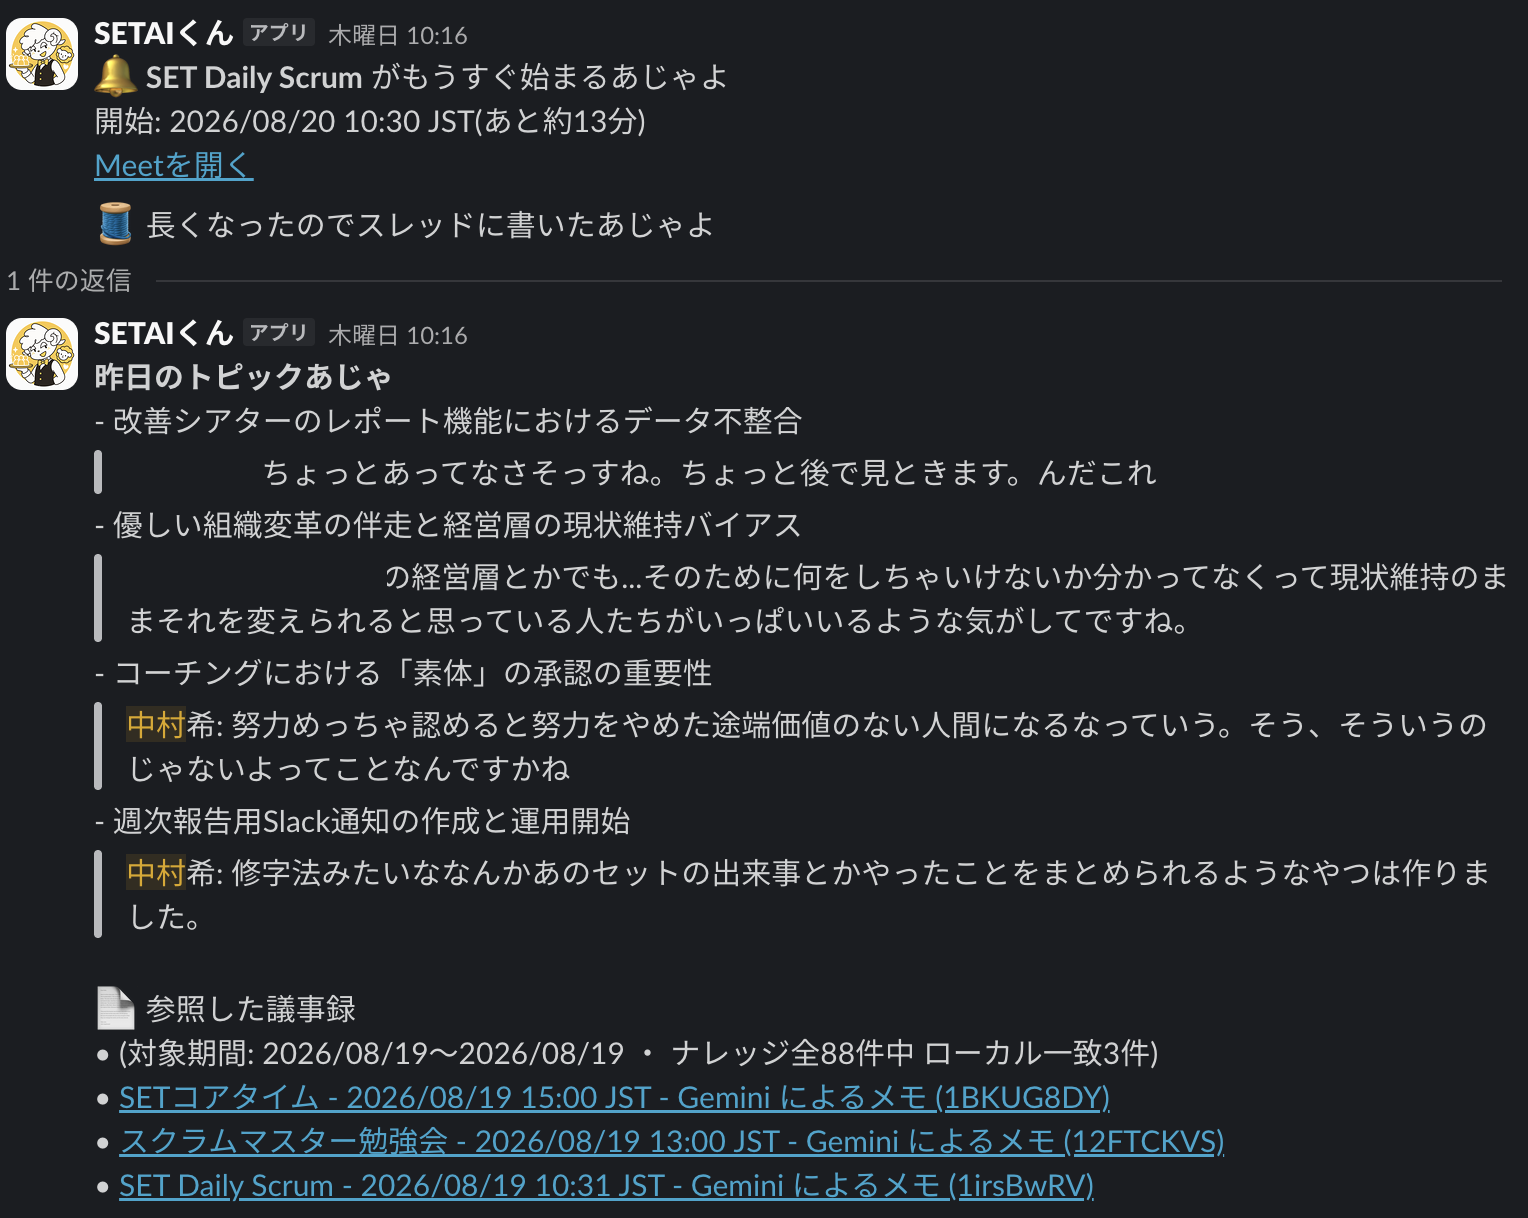
会議の直前に、その会議に関連する過去の文脈をチャットアプリへ問い合わせ、要約をSlackへ通知する定期実行ワークフローです。
会議ごとに問い合わせ内容のプロファイルを変えています。
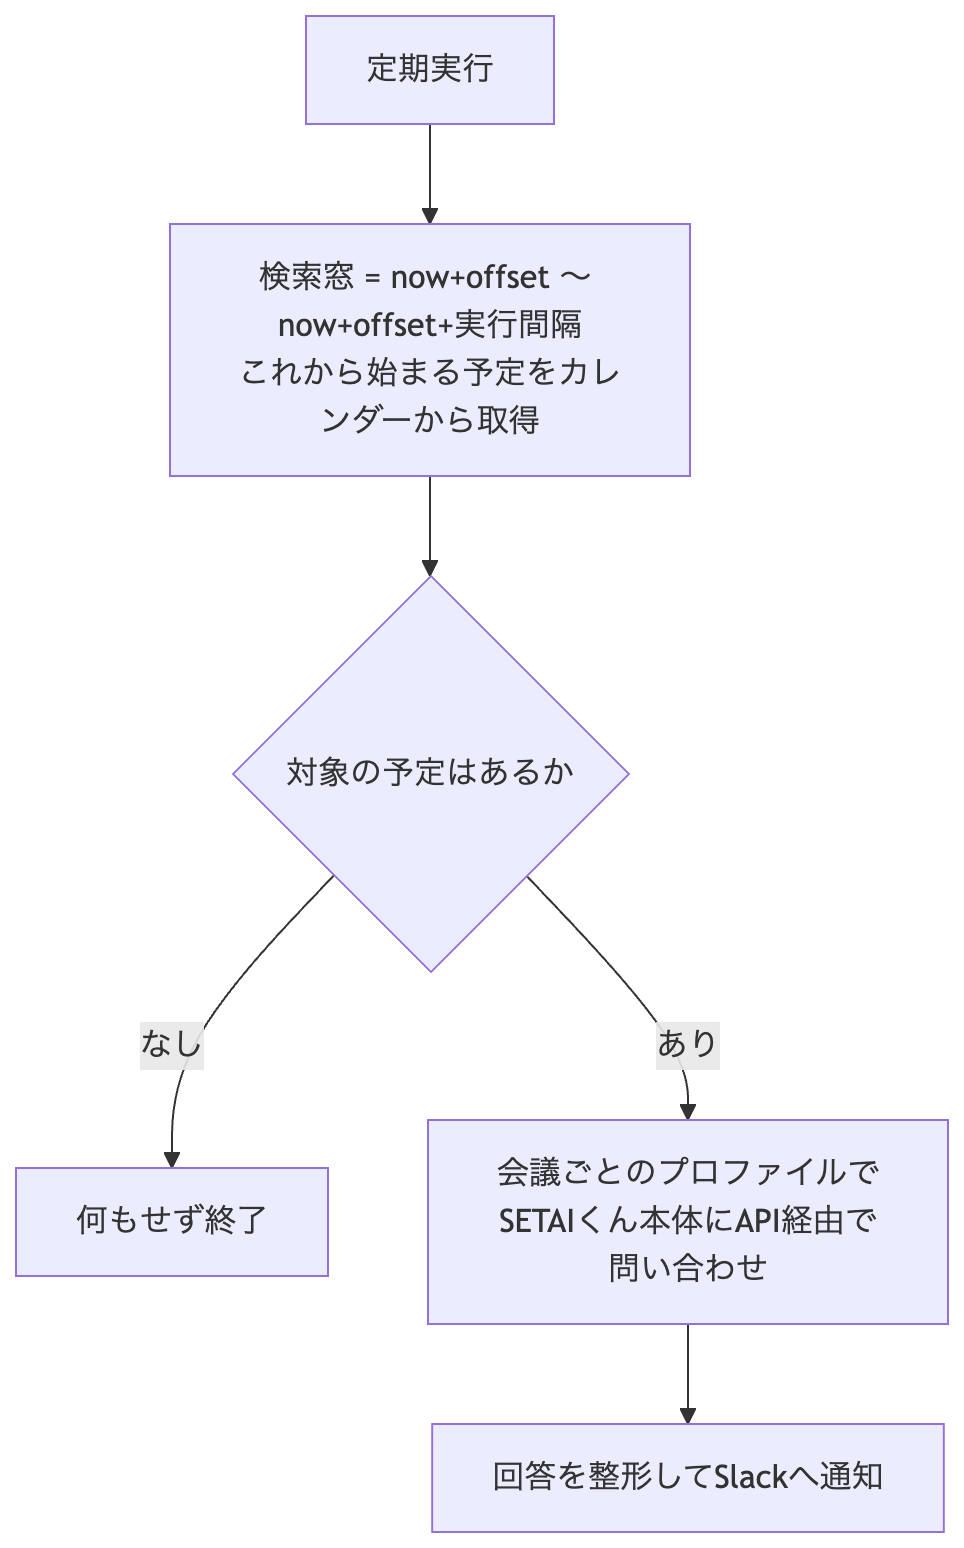
ここで意識したのは、ワークフローが実行間で状態を保持できないという制約でした。
検索窓(今回の場合、これから始まる予定をどこまで先まで見るかの範囲)の長さを実行間隔と一致させることで、状態を持たずに重複通知と取りこぼしの両方を防いでいます。
過去に遡る窓ではなく未来だけを見る設計にしていること自体が、重複通知に対する主な防御にもなっている。
なお会議ごとのプロファイルは以下のようにしています。
デイリースクラム:昨日1日分の議事録すべてを参照して、昨日のトピックを3〜6個列挙(25行以内)
レトロスペクティブ:直近14日分を横断参照して、今スプリントの活動まとめ・学び/気づき・hurikaeri.jp カタログに沿ったおすすめふりかえり手法3つ(35行以内)
それ以外:同名会議の直近2回分(無ければ2営業日前までの記録)を参照して、前回の内容まとめ+今回話すと良さそうなこと(25行以内)
⑤週次レポート:1週間分をスプリントレビュー形式にまとめる
1週間分のサマリーを統合し、スプリントレビュー形式(その期間に「やったこと」をふりかえる形式)のレポートを生成してSlackへ通知する定期実行ワークフローです。
Slackに流れた週報を人が手動で社内のOutlineに転記しています。
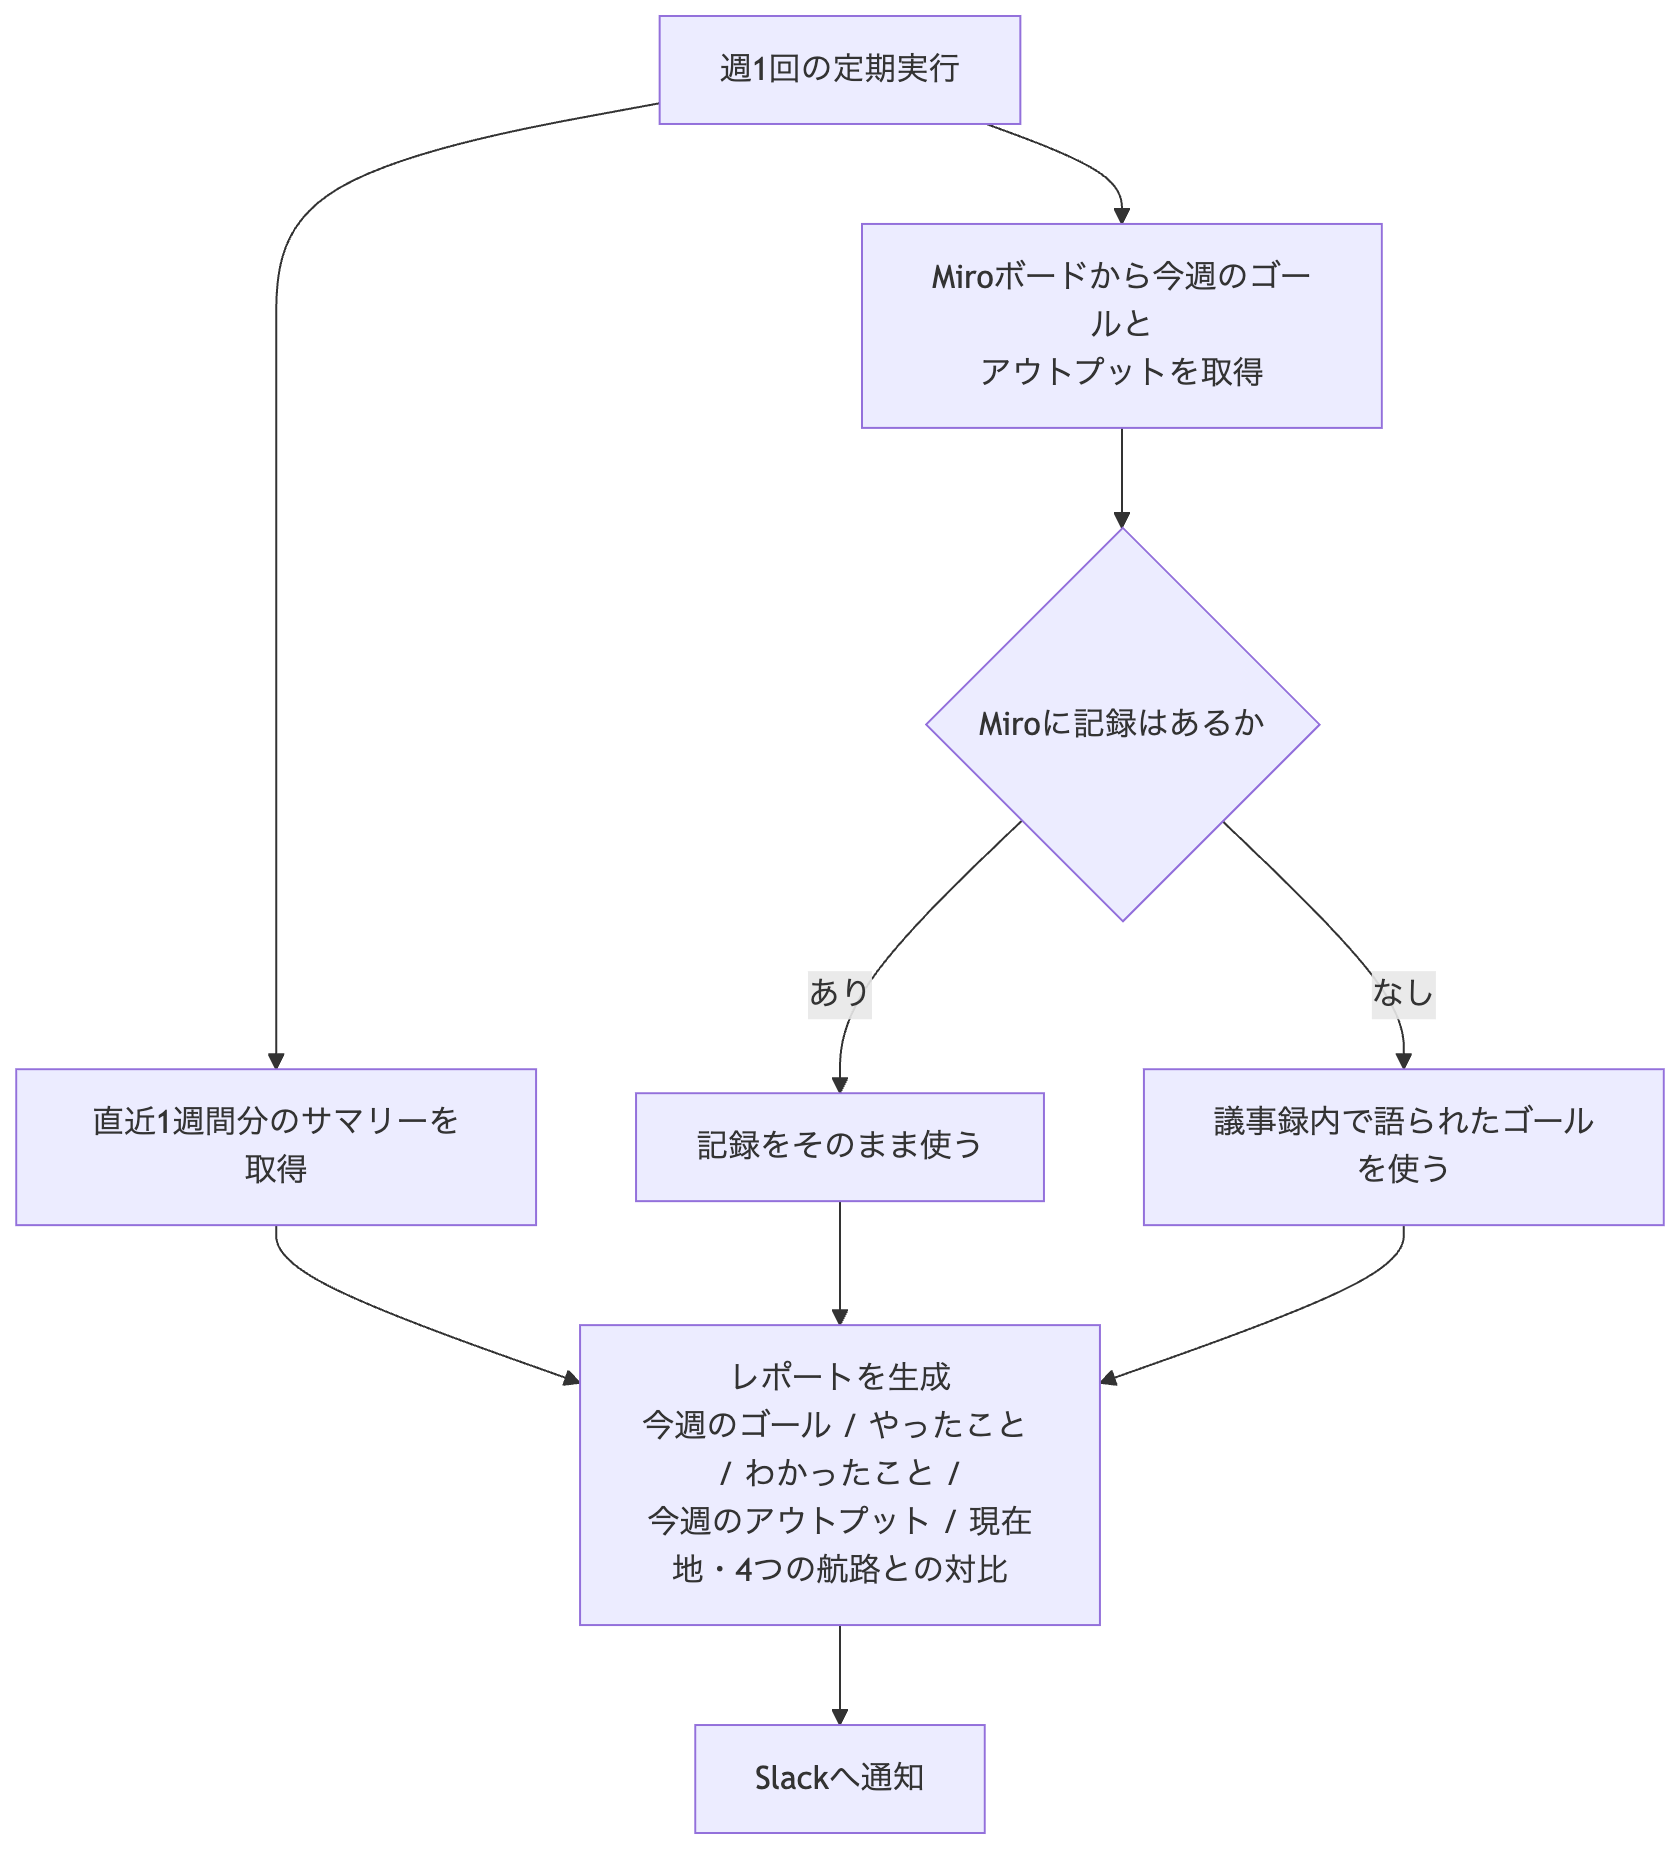
冒頭で「議事録やMiroに散在していて」と書いたが、Miro側の情報を拾っているのがこのワークフローです。
スプリントのゴールと成果物はMiroボードに置かれているので、それをMCP経由で取得し、レポートの「今週のゴール」「今週のアウトプット」に流し込んでいます。
Miroに記録が無い週は、議事録の中で明示的に語られたゴールを使い、それも無ければ「特に定めていなかった」と書かせます。
プロンプト側では、記録があるときは改変せずそのまま使うよう明示しています。
AIに要約させると、せっかくチームが書いた言葉が別の表現に置き換わってしまうからです。
レポートの最後には、チームが掲げる4つの航路と今週の活動を対比させたセクションを置いています。
⑥日次の一言:状態を持たずにテーマをローテーションする
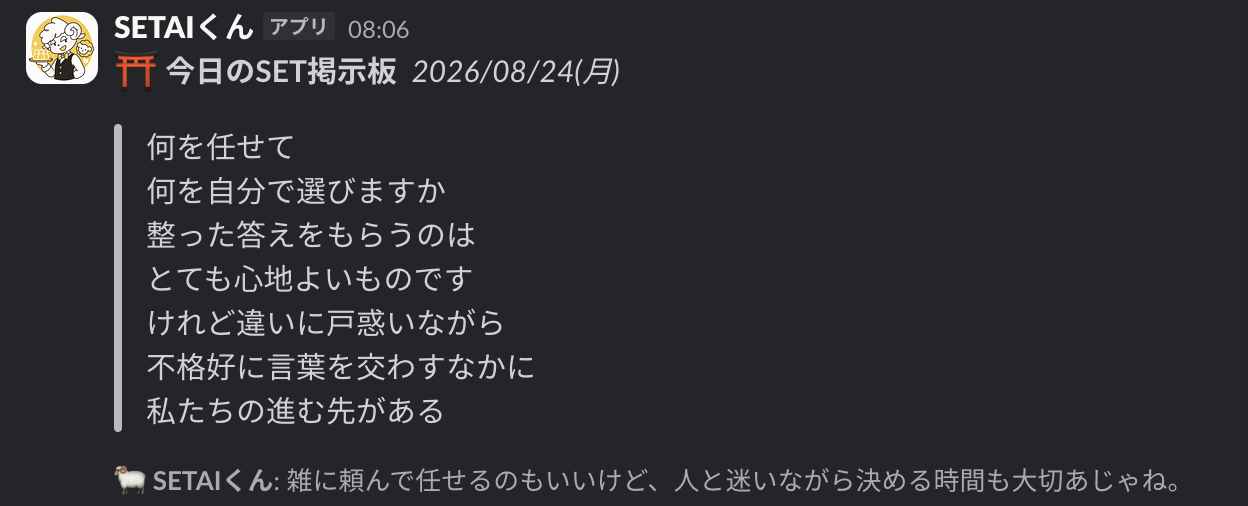
平日朝に、チームの文脈を踏まえた短い一言をSlackへ通知する定期実行ワークフローです。
実用性は大きくないが、ボットの存在をチームに馴染ませる効果がありました。
正直にいうと、ジョークアプリです。
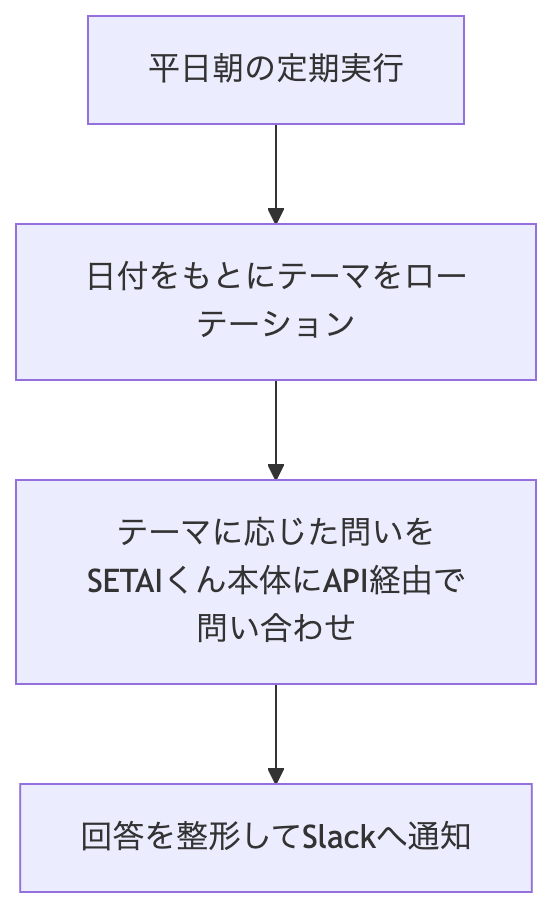
このワークフロー自体はナレッジベースを直接検索していません。
④予定リマインダーと同じく、SETAIくん本体をAPI経由で呼び出しています。
汎用的な格言ではなく、チーム自身の議事録に根ざした一言になるのはそのためです。
日付をもとに複数のテーマを機械的にローテーションさせることで、状態を持たずに内容の重複を避けています。
こうした一連のワークフローに共通するのは、一度に全部を作ろうとしなかったことです。
新しい処理はまず上限1件で動作を確認し、問題なければ上げる、という進め方を徹底しました。
LLM呼び出しを含むバッチは失敗時のコストが読みにくいため、最小の件数で1周させてから広げるほうが結果的に速いです。
まだうまくいっていないこと
チャットアプリをslackなどのチャットツールから直接呼び出す連携は、まだ実現していません。
GCPなど予算がかかることもあり、現状の運用でどれくらい成果があるかを観察してから動くためです。小さく作って、大きく育てる。この方針は変わりません。
ドキュメント数が増えた場合への備えも足りていません。
一部のワークフローは一覧取得が1ページ分で足りる前提のロジックになっており、件数が増えると重複判定が壊れる可能性があります。
チャット本体の「ヒットした文書は全文渡す」方式も、議事録が増えるほどコンテキスト長やコストの面で限界が来やすいです。
サマリー用ナレッジベースの方をSETAIくんの検索対象に使う案も検討中です。
検索精度のチューニング(ハイブリッド検索の重み、再ランクの設定、取得件数)も、実運用しながら継続して調整している段階です。
アジャイル的に見えてきたこと
技術的な話が中心だが、作る過程でスクラム支援チームらしい気づきもいくつかありました。
AIで速く実装できるようになったからこそ、フルスペックで大きいものを作ると無駄が増えます。
今回も機能を諦める判断を何度かしていて、小さく作って検証を積み重ねるという視点は、実装速度が上がるほど価値が上がると感じています。
議事録をAIに読み込ませることで、都度の再指示なしに文脈が通じるようになったことも、「AIに対してもチームとしての透明性を高める」という言い方で整理されました。
裏を返すと、AIに渡せる形で情報が整理されていないチームは、AIの恩恵も受けにくいということでもあります。
おわりに
あなたのチームの議事録も、眠っているのではないでしょうか。
それを起こしてみて一番に残ったのは、成果の大きさより、これだけ自由にAIで仕事をいじれたことの楽しさでした。
"All work and no play makes Jack a dull boy."
仕事ばかりで遊ばないジャックは、退屈な少年になる。
実用性の薄い「日次の一言」を作ったり、語尾を「あじゃ」にしたのも、この感覚に近いです。
ほんの少しのウィットが、仕事と人生を豊かにします。
眠った議事録を起こすと、ふりかえりが楽になるだけでなく、その余白まで運んでくれます。
まずは、あなたの現場で眠っている議事録に目を向けて見るところからいかがでしょうか。
この記事が役に立ったと思ったら、
ぜひ「いいね」とシェアをお願いします!
この記事を書いた人


他サイトでも楽しめます
What is BEMA!?
Be Engineer, More Agile