

 スクラムマスター(21)
複雑なドメインに挑むAI駆動開発:戦略的DDDで境界を切り、規律でAIを導く実践
 アーキテクチャ


はじめに
こんにちは!社内プロダクト開発チームでPM兼開発エンジニアをしている村松です。
うちのチームは、要件定義から実装、レビュー、ナレッジ化まで、開発のほぼ全工程に AI を組み込んで動かしています。
やってみて1つ分かったのは、ただ賢いモデルを使うだけでは足りない、ということでした。
複雑なドメイン、更新されていく情報を実装に落とし込むのに効いたのは、戦略的DDDでコードの境界を切り直したことと、その境界を AI に守らせるためのルールを書き下したことです。
ただし、これは「こうするのが正解」という話ではありません。定量的な成果を示せる段階ではないため「いまのところこう積んでいて、ここまでは来た」という報告として読んでいただけると幸いです。
📝 対象は社内向けの業務システムで、業務名をそのまま出せません。本稿ではディレクトリ名やモジュール名を、等価な複雑さの別ドメイン(購買 / 調達)に置き換えて説明します。構造の話はほとんど変わっていません。
背景・課題
手法の話に入る前に、前提を共有します。ここが違えば、同じやり方は効きません。
作っているのは、複数の業務領域を横断する社内向けの業務システムです。
領域ごとに登場人物もルールも異なり、それらが互いに参照し合います。
いわゆる「ドメインが複雑」な部類です。
長期にわたって育てていく前提ですが、一方で開発の人手は限られています。
この3つが重なったとき、うちでは AI に任せる範囲を広げる方向に賭けることにしました。
ところが、任せる範囲を広げるほど別の問題が出てきました。任せきると壊れる。設計の意図から外れたコードが増え、レビューで潰す量が増え、結局スピードが出ない。
「AI に広く任せたい」と「任せきると壊れる」。理想と現実のジレンマをどう両立させるか、どう付き合っていくのか。これがこの記事の主題となります。
AI駆動開発のアプローチ
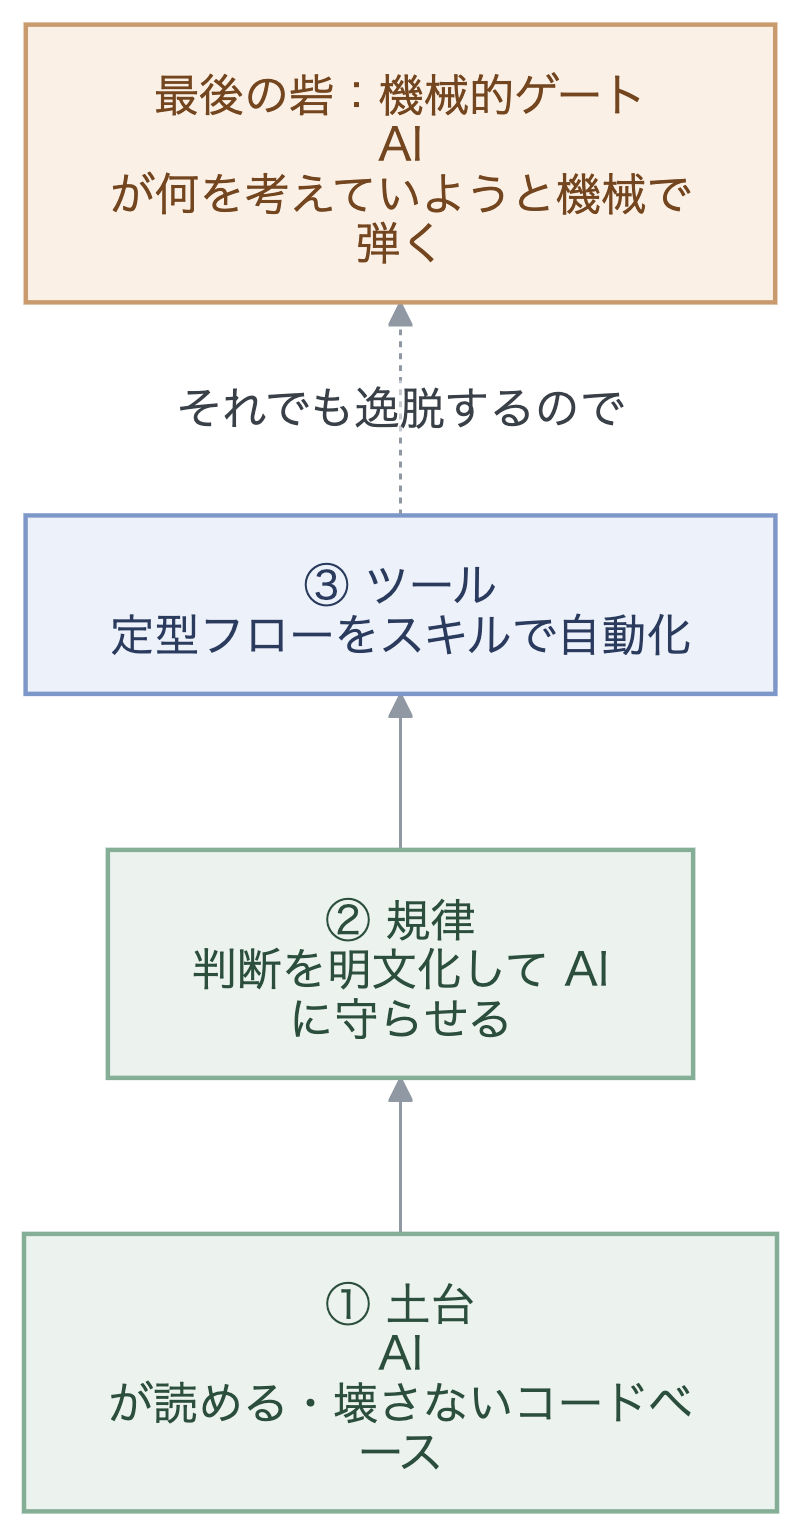
うちの AI駆動開発は、大きく3層で捉えています。下の層が崩れていると、上の層は機能しません。そしてその3層の外側に、もう一枚ゲートを置いています。
1. 土台:戦略的DDDでコードの境界を切る
一番効いたのがここです。
DDD というと集約や値オブジェクトといった戦術的パターンが有名ですが、本来の肝は戦略的DDD、つまり境界づけられた文脈(Bounded Context)を切ることのほうだと思っています。業務領域ごとにモデルと言語を分ければ、複雑性がその中に閉じ込められます。
これが AI と相性がよかったです。1つの機能を直すのに読むべきコードが、1つの文脈の中に収まるからです。AI に渡すコンテキストが小さくて済むし、越境した瞬間に「それは別の文脈の言葉だ」と判断できます。
運用をシンプルにするためにモノレポでやりたかったので、マイクロサービスまで分割せず、1つのプロセスの中をモジュールできっちり区切るモジュラーモノリスにしました。さらに、1つの機能に関わるファイルが1つのフォルダにまとまっていてほしかったので、レイヤーではなく機能の縦串、Vertical Slice でパッケージングしています。
結果、境界づけられた文脈(Context)と Vertical Slice(Slice)を構造の2軸にした形に落ち着きました。
apps/api/src/
└── modules/
    ├── identity/                      ← 境界づけられた文脈(Context)
    │   ├── contracts/                 ← 他コンテキストへの公開境界(ここ経由のみ許可)
    │   ├── domain/                    ← プレーンオブジェクト + 純粋関数(class なし)
    │   ├── schema/                    ← テーブル定義
    │   └── features/                  ← Vertical Slice(Slice)
    │       ├── get-current-user/      ← 参照のみ。handler + query のフラット構成
    │       │   ├── handler.ts
    │       │   └── query.ts
    │       └── google-auth/           ← ルールあり。複数ファイルに展開
    │           ├── handler.ts
    │           ├── begin-oauth.ts
    │           └── user-repository.ts
    ├── purchase-order/
    │   └── features/
    │       ├── list-purchase-orders/  ← handler + query
    │       └── assign-approver/       ← handler + usecase + repository
└── supplier/今でこそこの構造になっていますが、もともとはクリーンアーキテクチャに倣った構造でした。
層を分け、依存方向を内側に揃え、ドメインは外界に依存しない形の、どこかの記事でよく見る構成です。
ですがクリーンアーキテクチャに不慣れな開発者がAI駆動開発に取り組んだとき、水平方向にレイヤーで切ると、水平的に儀式的なコードが増え、1機能を直すのに関連コードがあちこちに散らばり、レビュー負荷も上がりました。
過去のそういった課題から、一度大きくリアーキテクチャして今の形に至っています。
2. 規律:切った境界を AI に守らせる
文脈を切っただけでは守られません。 AI(と人)は油断するとすぐ越境します。
そこで CLAUDE.md(プロジェクト全体の常時ルール)と .claude/rules/(触っているファイルのパスに応じて効くルール群)に、設計判断を書き下しています。家にたとえると、玄関に貼ってある「靴を脱ぐ」が CLAUDE.md、各部屋に貼ってある「この部屋ではこれを使う」が .claude/rules/ です。AI はファイルを触るたびに該当ルールを読み、その文脈に合った作法でコードを書く。
肝心の越境については、modules 配下に効くルールで「他コンテキストを参照するときは contracts/ 経由のみ」と縛っています。ほかにも domain 配下には class 禁止と純粋関数、TypeScript ファイル全体には as と any と enum の禁止というように、効く範囲を切り分けてあります。粒度は一文の禁止か必須まで落とします。
as 型アサーションは禁止。型ガードか根本修正で対応する
any は禁止。unknown で受けて型ガードか Zod で絞る
AI はファイルを触るたびに該当ルールを読むので、毎回違う作法に散らばらず、同じ書き方に収束します。
ただ、複雑なドメインを扱う以上、完璧に合理的な意思決定などは存在せず、常にトレードオフの中で決めていくことになります。そんな判断の蓄積を暗黙知にしないよう、docs/decisions/ に ADR(Architecture Decision Record:アーキテクチャ判断記録)として残しています。
3. ツール:定型フローをスキルで自動化
土台と規律ができたら、その上に乗せるのがツールです。要件定義から実装計画までの定型フローを、Claude Code のカスタムスキルとして実装しています。起点のスキルが対話で要件を引き出し、回答内容に応じて次のスキルへ自動で振り分ける流れです。
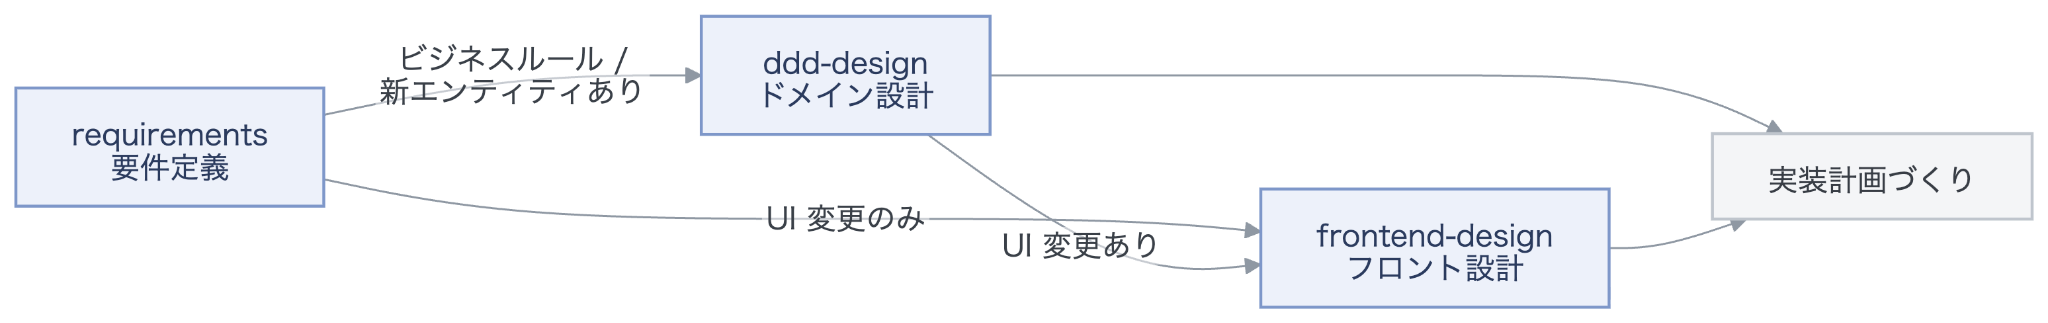
各スキルには、設計が承認されるまで実装に進めない HARD-GATE が明文で埋め込まれています。AI が要件確認を飛ばして実装に突っ走るのを、構造的に止める仕掛けです。
AI の判断に頼らない「機械的ゲート」
ここで少し思想が反転します。
ここまでの3層が「AI がうまく働けるように環境を整える」話でした。一方この最後のゲートは、その逆「AI を信頼しない」前提に立つ仕組みです。
というのも、3層はどれだけよくできていても、最終的には AI の判断に依存しているためです。ルールは読み飛ばされうるし、スキルのゲートも「AI がちゃんと従えば」効くもの。少なくとも今のところの運用では、逸脱をゼロにはできていません。
そのため、AI が何を考えていようと機械的に弾くゲートを重めに置きます。
手元の pre-commit では Lint と各種自動生成を走らせ、CI では Lint、型チェック、テスト、マイグレーションの整合まで通す。手元は軽く保ってコミットの待ち時間を抑えつつ、マージの手前では必ず全部通す分担です。
AI駆動開発の流行以前にも、Lintや型チェックは設けられていましたが、AIによってコードを書く機会がほとんど減った今、実行する頻度やメンテナンスする比重は、以前より高くなっていると感じています。
言葉のルールを機械で強制する、はずだった
ここにもう一枚重ねたかったのが、境界チェック(dependency-cruiser)です。「越境は contracts/ 経由のみ」とルールに言葉で書いていましたが、それを機械で強制しようという話です。他コンテキストの内部への直接 import や、隣の feature からの import を、問答無用で error にするような仕組みです。
ただ、この境界チェックは現在止まっています。
TypeScript 7(Go によるネイティブ実装)へ移行したところ、dependency-cruiser が 7 系の Compiler API に未対応で、走査対象0件のまま何も検出せずに緑になる状態になってしまいました。「静かに全部パスする」のは、動いていないより性質が悪い。そのため CI と pre-commit からは外し、設定だけ残して復旧待ちにしています。結果として、AI を信頼しないための仕組みのほうが先に動かなくなりました。
境界チェックが落ちても Lint も型チェックもテストも動いていますし、その上には明文化されたルールと人間の承認ゲートがあります。結果的に他の層が受け止めた形で、機械的ゲート自体も壊れるものだと考えるようになりました。
ですが戦略的DDDの面で考えると、AIに黙って境界侵害されてしまう状態だと、ゆくゆくはそのコンテキストが前提としている境界が保てなくなり、ドメインモデルの品質も落ちてしまいます。
今後、Biomeのカスタムルールによって弾くなどの代替手段は必要です。
実践と結果
この3層は一気に出来たものではなく、痛い目を見ながら徐々に積み上がってきたものです。いまはカスタムスキルが一通り揃い、パスごとに効くルールが配置され、ADR に設計判断が蓄積されて後から辿れる状態になっています。pre-commit と CI の機械的ゲートも走っていて、通らないものはマージされません。一方で境界チェックだけは前述のとおり停止中です。
まとめ
最後に、ここまでの話が実際の開発でどう繋がって回るのか、全体像を1枚にまとめておきます。
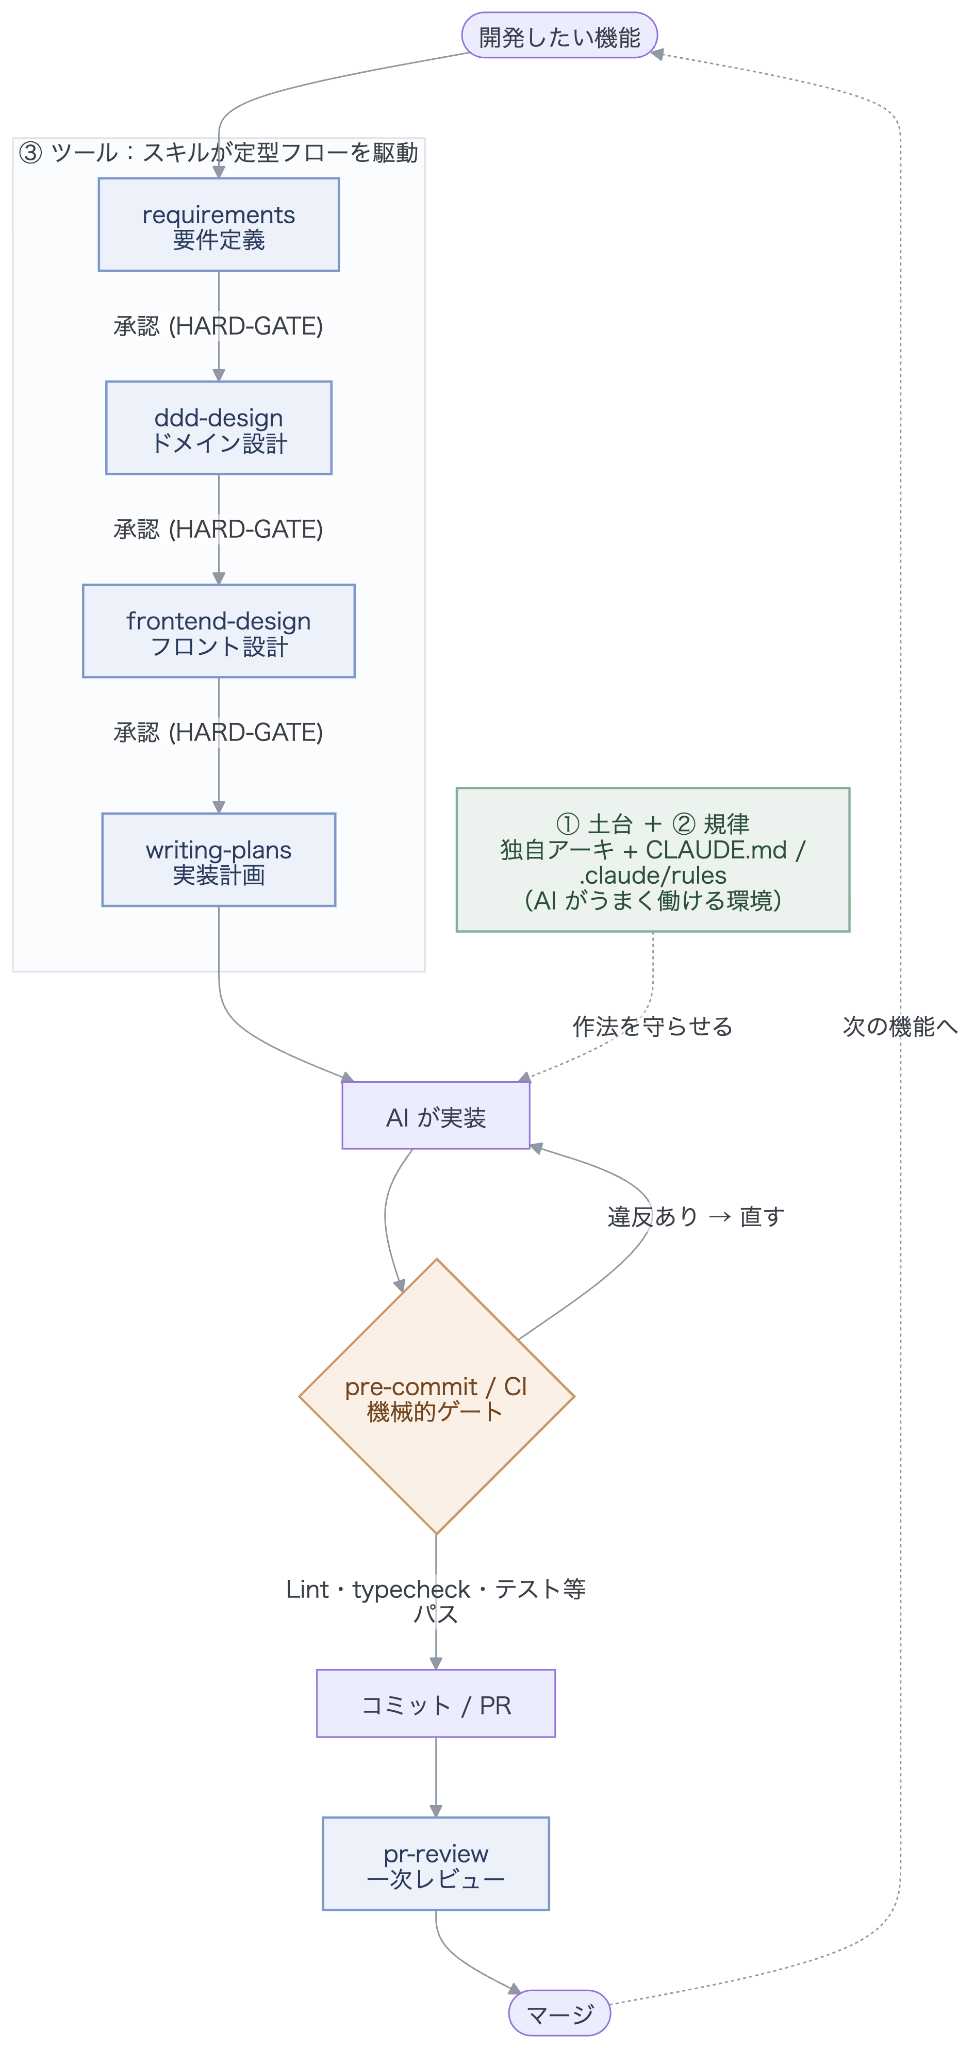
横の流れはスキルが駆動し、節目ごとに人間の承認ゲートが挟まる。それを下から支える戦略的DDDの境界と規律が AI の書き方を揃え、最後に機械的ゲートが「守れていないコミット」を通さない形です。
ここで挙げた仕組み自体は、特定の言語やフレームワークに強く紐づいたものではないと思っています。ただ、同じやり方が他の現場でも効くかどうかは分かりません。
いまのところ実感しているのは、少なくともうちの場合、賢いモデルを使うだけでは足りませんでした。AI が力を発揮できる環境を整えることと、その上で AI を盲信せず品質を機械的に守ること。この両輪でようやく回り始めた感覚があります。
肝要なのは、人間がオーナーシップを手放さないことだと思っています。
AI に気持ちよく働いてもらいつつ、その出力は当てにしすぎない。このバランスはまだ手探りで、これから見極めていきたいところです。
この記事が役に立ったと思ったら、
ぜひ「いいね」とシェアをお願いします!


他サイトでも楽しめます
What is BEMA!?
Be Engineer, More Agile