

 スクラムマスター(21)
「量子コンピュータは100億通りを同時に計算する」は本当?──量子並列性の誤解を解く
 Webエンジニア


はじめに
「量子コンピュータは、膨大な数の組み合わせを同時(並列)に計算できる」
量子コンピュータの紹介で、よく見かける説明です。直感的で分かりやすい一方、この言葉だけを受け取ると、「100億台のCPUが並列に動いている」「100億件の計算結果を一度に取得できる」といった誤解につながります。この説明には量子並列性の重要な制約が抜け落ちています。
量子コンピュータは、多数の入力に対応する成分を重ね合わせた状態に対して、一つの量子回路を作用させられます。ここで言う「重ね合わせ」とは、あらゆる答えの可能性が「波」のように重なり合って同時に存在している状態のことです。
しかし、そこからすべての計算結果を一覧として読み出せるわけではありません。最後に状態を「測定(観察)」した瞬間、波は一変して、どれか一つの結果だけに確定してしまうからです。
多くの量子アルゴリズムで重要なのは、候補をただ重ね合わせることではなく、波の「干渉」を利用することです。水面の波がぶつかると大きくなったり消えたりするように、計算の波を干渉させ、目的の情報が測定結果へ現れやすい状態(確率が100%に近づく状態)を作ることです。IBM Quantumの教材 でも、量子の重ね合わせは古典的な確率表現より強力である一方、「指数個の独立した計算を行う並列処理」と同じではないと整理されています。
この連載を始めた背景は、前回の記事「DX現場に伴走するエンジニアが、いま量子コンピューティングを学ぶ理由」で紹介しています。
今回は、Webエンジニアが慣れている並列処理と比較しながら、「同時に計算する」のどこまでが正しく、どこから誤解が生まれるのかを整理します。
まず、古典コンピュータの並列処理を考える
Webシステムで100億件の入力を処理するなら、複数のCPUコア、GPU、コンテナ、ワーカーへ処理を分割できます。
たとえば、ワーカーAは入力0、ワーカーBは入力1、ワーカーCは入力2を担当し、最後にそれぞれの出力を集約します。十分な計算資源があれば、処理時間を短縮できます。
重要なのは、各処理が独立した実行単位であり、原理的にはそれぞれの結果を個別に回収できることです。
量子コンピュータの「並列性」は、これとは異なります。量子ビットの中に小さなCPUが大量に存在し、それぞれが別の入力を処理しているわけではありません。
この違いを、処理の流れとして並べると次のようになります。
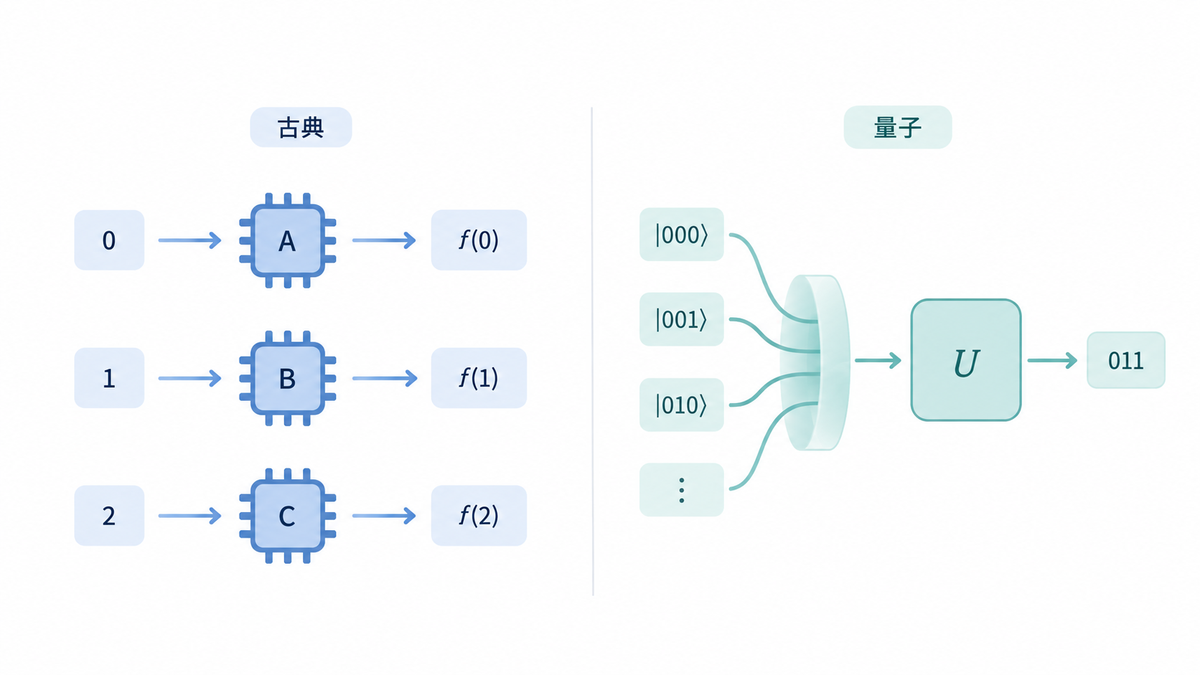
左側では処理と結果がそれぞれ独立しています。右側では、複数の基底状態に対応する成分を持つ一つの量子状態へ、一つの量子回路が作用します。
※ |010> のような表記は「ケット記法」と呼ばれ、3つの量子ビットがそれぞれ「0」「1」「0」の状態にあることを示しています。
n量子ビットの状態は、2^n個の基底状態の振幅で表される
古典ビットがn個あると、ある時点で保持するビット列は一つです。
3ビットなら、000、001、010、……、111の8通りのうち、実際に保持しているのはどれか一つです。
一方、理想的な状態ベクトルの表現では、n量子ビットの状態は、2^n個の基底状態に対応する確率振幅で表されます。基底状態とは、000や101のような、測定結果の候補となるビット列に対応する状態です。
3量子ビットなら8個です。34量子ビットなら、
2^34 = 17,179,869,184となり、約172億個の基底状態が状態ベクトルの記述に現れます。この性質が、「量子コンピュータは膨大な組み合わせを同時に扱う」と説明される背景です。
ただし、172億個の通常の値や答えを、メモリ上の配列として保存しているわけではありません。各基底状態に対応する確率振幅は、符号や位相を持つ複素数です。量子ゲートは、それらを含む一つの量子状態を変化させます。
したがって、
"172億通りを、172億台のワーカーで個別に計算している"
と捉えるのは不正確です。より近いのは、
"172億個の基底状態に対応する振幅を持ち得る、一つの量子状態を操作している"
という理解です。
一度の測定で、すべての結果は読めない
仮に多数の入力を重ね合わせた状態で計算しても、一度の実行と測定(1 shot)で得られるのは通常、一つの古典的なビット列です。
3量子ビットを計算基底で測定すれば、000から111までのどれか一つが得られます。8通りすべてが一覧で返るわけではありません。どの結果が得られるかは、各振幅の絶対値の二乗から決まる確率に従います。
ここが、古典的な並列処理との決定的な違いです。
100億台のワーカーがあれば、原理的には100億件分の出力を回収できます。しかし、100億通りに対応する重ね合わせを作っても、1 shotで100億件分の答えを取得することはできません。
実際のSDKやクラウドサービスでは、一つのジョブで同じ回路を複数shots実行し、測定結果の度数をまとめて返すことがあります。ここでいう「一度」は、APIレスポンスやジョブの回数ではなく、1 shotです。shotsを重ねれば結果の分布は調べられますが、全候補に対応する計算結果を一覧として取得できるわけではありません。
シミュレーターでは状態ベクトルを計算上確認できる場合がありますが、それは実機から同じ情報を一度に読み出せることを意味しません。
では、すべての答えを取り出せないのに、重ね合わせを使う意味はどこにあるのでしょうか。
量子アルゴリズムは、量子回路として表現される
ここで、Webエンジニアの視点から、「量子アルゴリズム」がどのような形をしているのか整理しておきます。
「アルゴリズム」と聞くと、プログラミング言語で書かれた処理や疑似コードを思い浮かべる人が多いと思います。私自身も、量子アルゴリズムを学び始めたとき、「どの言語で書くのか」「どこを見れば処理の流れが分かるのか」が気になりました。
この記事で扱うゲート型量子計算では、アルゴリズムの量子部分は、量子ゲートを並べた量子回路として表現されます。回路図では、横線が量子ビット、箱や記号がゲート操作を表し、基本的に左から右へ処理が進みます。
実際に動かすときは、QiskitなどのSDKでコードを書きます。しかし、そのコードが組み立てているのは、「どのゲートを、どの順番で、どの量子ビットへ適用するか」という回路です。回路図は単なる説明用のイラストではなく、量子デバイス上で実行する処理を表しています。
ただし、量子アルゴリズム全体が回路だけで完結するとは限りません。測定結果の後処理や、回路パラメータの更新を古典コンピュータで行う場合もあります。それでも、量子デバイス上で何を実行するかは、回路図として目で追えます。
古典プログラムでは、変数、分岐、ループ、関数呼び出しを追って処理を理解します。ゲート型量子計算では、どこで重ね合わせを作り、どこで問題に応じた位相を与え、どのゲートで再び成分を混ぜ、どう測定へつなげるかを回路として読みます。
この見方を知ったとき、量子アルゴリズムは「見えない数式の塊」ではなく、ゲート操作の流れとして読めるものだと分かりました。既存のプログラムとは形が大きく違いますが、処理の流れを設計するという意味では、プログラマーが理解できる対象です。
重要なのは、重ね合わせた後の「干渉」
量子状態の振幅には、波のような強め合いと打ち消し合いがあります。
多くの量子アルゴリズムでは、問題が持つ構造を利用して、目的の性質に関係する成分が測定結果へ反映されやすくなるように量子回路を設計します。不要な成分を完全に消せるとは限りませんが、干渉によって測定結果の確率分布を変えられます。
ここで大切なのは、量子コンピュータが正解を事前に知り、直接選んでいるわけではないことです。
複数の計算経路がどのように干渉するかを設計し、最後に取得できる限られた測定結果へ、必要な情報を集約する。そこに量子アルゴリズムの工夫があります。
たとえば1量子ビットのごく小さな例でも、量子回路は次のような情報の流れを持っています。
- 最初のゲートで重ね合わせを作る
- 途中の操作で、特定の成分に相対位相を与える
- 後段のゲートで成分を再び混ぜ、干渉を起こす
- 干渉の結果として、測定で出やすい状態が変わる
下図は、通常の回路図に状態成分の変化を重ねた模式図です。「位相に埋め込んだ情報を、後段のアダマールゲート*で測定確率の差へ変換する」という流れを示しています。
※アダマールゲート(Hゲート)とは、量子コンピューティングにおいて、量子ビットを「0」と「1」の重ね合わせ状態(0と1が半々の確率で観測される状態)に変換する、最も基本的な1量子ビットの量子ゲートです。
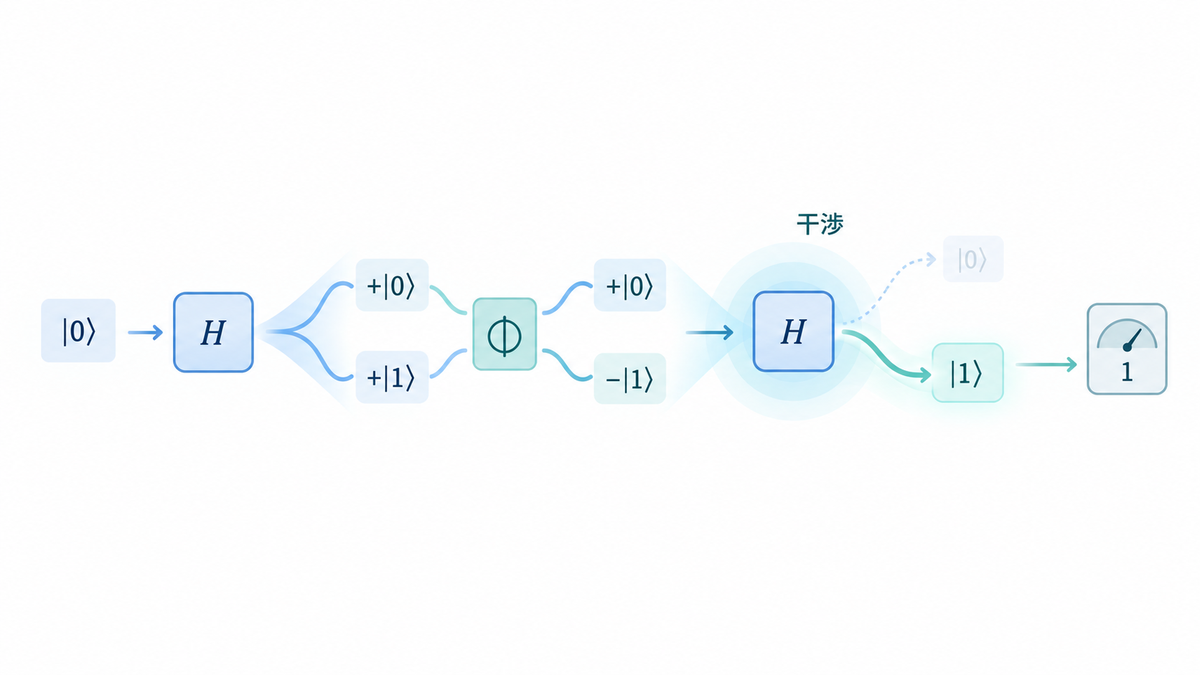
図の分岐は、量子ビットが物理的に二つの経路へ分かれる様子ではなく、量子状態を構成する成分を模式的に表しています。途中で付けた位相差は、後段のアダマールゲートで成分を再び混ぜることで干渉し、測定確率の差として現れます。
コイン投げでは説明できないこと
重ね合わせは、よく「投げている途中のコイン」にたとえられます。
測定すると0か1のどちらかが得られる点では役立つ比喩です。しかし、古典的なコイン投げの確率モデルには、量子状態の相対位相に対応する要素がありません。そのため、振幅の強め合いや打ち消し合いを説明できません。
先ほどの図では、重ね合わせの後に位相差を与えたため、最後は|1⟩が残りました。では、途中の位相操作を入れず、アダマールゲートを2回続けて適用するとどうなるでしょうか。
1量子ビットを|0⟩から始め、アダマールゲートを1回適用すると、0と1が同じ確率で測定される重ね合わせになります。
H|0⟩ = (|0⟩ + |1⟩) / √2
H|1⟩ = (|0⟩ - |1⟩) / √2ところが、同じアダマールゲートをもう1回適用すると、理想的には|0⟩へ戻ります。
H(H|0⟩)
= 1/2 { (|0⟩ + |1⟩) + (|0⟩ - |1⟩) }
= |0⟩|0⟩へ向かう二つの振幅は強め合い、|1⟩へ向かう振幅はプラスとマイナスで打ち消し合います。
「ランダムなコインをもう一度投げたら、必ず表に戻る」と考えると不自然です。ここに、古典的な確率と量子状態の違いがあります。
量子計算を理解するには、測定後の確率だけでなく、測定前の振幅と相対位相を見る必要があります。
「全入力に作用する」だけでは足りない
量子並列性の説明では、入力xを重ね合わせにし、関数f(x)に相当する量子回路を適用すると、多数のxに対応する成分が一つの状態変換の中で同時に変化する、と説明されます。
この意味では、「複数の入力を同時に計算する」という表現にも根拠があります。
しかし、その直後に測定しても、全入力に対するf(x)をCSVとして出力することはできません。量子アルゴリズムが狙うのは、個別の結果をすべて読むことではなく、たとえば次のような情報です。
- 関数全体が持つ性質
- 条件を満たす入力
- 隠れた周期や位相
Deutsch–Jozsaアルゴリズムは、関数が「すべての入力で同じ値を返す定数関数」か、「入力の半分で0、残り半分で1を返す均等関数」かのどちらかだと約束された問題を判定します。全入力の出力を一覧にするのではなく、量子並列性と干渉を組み合わせ、関数全体の性質を限られた測定結果へ反映させる例です。
量子並列性だけでなく、「測定で何を取り出せるように設計するか」が重要だと分かります。
状態空間が大きいだけでは、高速化にならない
n量子ビットの状態が2^n個の振幅で表されることと、任意の問題を2^n倍速く解けることは別です。
重ね合わせを作るだけなら、欲しい情報を取り出せないまま測定して終わります。実際の計算では、問題を量子回路へ写す方法、古典データを量子状態へ符号化するコスト、回路の深さ、ノイズ、必要なshots数、古典コンピュータ側の後処理も考えなければなりません。
状態空間の大きさは量子計算の可能性を支える要素ですが、それだけで高速化を保証しません。量子計算と相性のよい問題構造と、それを利用するアルゴリズムが必要です。高次元の状態を扱えることだけでは、古典計算に対する優位性の十分な説明にならないことも指摘されています。
これはGPUにも少し似ています。GPUのコア数が多くても、ハードウェアの性質に合わない処理では性能を引き出せません。
ただし、量子コンピュータはGPUの超大型版ではありません。似ているのは、ハードウェアの性質に合ったアルゴリズム設計が必要であるという点だけです。
より誤解の少ない言い換え
「量子コンピュータは100億通りを同時に計算する」を、より誤解が少ない形に言い換えるなら、次のようになります。
量子コンピュータは、多数の基底状態に対応する振幅を一つの量子状態として変化させ、干渉を利用して、目的の情報が測定結果へ現れやすい確率分布を作る。
少し長くなりましたが、次の点を含んでいます。
- 多数の入力に対応する成分へ一つの回路を作用させられる
- 候補ごとの結果をすべて読み出せるわけではない
- 量子並列性を役立てるには干渉とアルゴリズム設計が必要
- 高速化の有無は問題とアルゴリズムに依存する
最後に
「量子コンピュータは膨大な組み合わせを同時に計算する」という説明は、重ね合わせや量子並列性への入口としては便利です。
しかし、それを「大量のCPUが独立して動く並列処理」と同じ意味で理解すると、重要な制約が抜け落ちます。
量子コンピュータは、たくさんの可能性を同時に計算できますが、私たちが最後に中身を覗き見(測定)した瞬間に、手に入る結果はたった一つだけになってしまうからです。
だからこそ量子アルゴリズムでは、すべての答えを同時に読み出そうとするのではありません。
ハズレの答えを「波の打ち消し合い」で消して、正解の答えだけを大きく浮かび上がらせる仕組みを作ること。 これこそが、量子並列性の本当の要点です。
ここまで理解すると、次の疑問が生まれます。
「1回につき1つの結果しか出ないなら、なぜ同じ計算を何度も繰り返すのか」。
次回は、量子計算を何度も実行して「正解の確率」を確かめる仕組みについて、コードを見ながら検証します。
技術者同士の学習の場でも、こうした「よくある説明を、どこまで誤解なく言い換えられるか」を、コードや一次情報を確認しながら議論しています。今後も、そこで生まれた疑問を一つずつ検証し、記事として共有していきます。
参考資料
IBM Quantum Learning「Quantum computing fundamentals
」IBM Quantum Learning「Superposition with Qiskit
」IBM Quantum Learning「Build and run your first quantum program
」IBM Quantum Learning「Quantum mechanics basics
」IBM Quantum Learning「The Deutsch-Jozsa Algorithm
」IBM Quantum Learning「Introduction to Quantum Machine Learning
」
この記事が役に立ったと思ったら、
ぜひ「いいね」とシェアをお願いします!
関連記事
- 【2026年9月版】人気記事ランキング|環境構築とデバッグの...
BEMALab 編集部
- 【2026年8月版】人気記事ランキング|Xdebug・AWS...
BEMALab 編集部

他サイトでも楽しめます
What is BEMA!?
Be Engineer, More Agile